Pi 系列的回顾:从 π₀ 到 π₀.₅
Published:
Pi 系列的回顾:从 π₀ 到 π₀.₅
本文整理 π 系列在数据配比、模型架构与流匹配动作生成方面的关键变化,并补充 π₀.₅ 的 Action Tokenizer、AdaRMS 与分层训练设计。
VLA 在过去一年发展迅速,但真正能在复杂任务上稳定工作的模型仍然不多。本文围绕移动操作长时程任务,回顾从 2024 年 10 月到 2026 年 4 月、从 π₀ 到 π₀.₇ 的架构演进,重点分析这些设计为什么有效。π₀ 首次提出时强调了两个关键点:模型架构要能够利用多源数据,并表示与复杂物理场景交互所需的细腻行为;同时还需要正确的数据配方。因此,本文也从数据配比和模型架构两条线索展开比较。
1. 数据配比
$\pi_0$
数据集包含约 10 万小时的演示数据,并辅以开源 OXE 数据集 [10]。每条数据都带有任务名称和分段标注。
- 预训练数据: 尽可能覆盖更多任务,并让每个任务中的行为保持多样。
- 后训练数据: 聚焦于更有助于完成目标任务的行为。
- 预训练数据: 由 OXE、Bridge v2 和 DROID 等开源数据集组成。这些数据集中的机器人和任务通常配备一到两个摄像头,并使用 2–10 Hz 的低频控制;自采数据则采用单臂与双臂约 1:8 的配比。每个任务由许多复杂子任务组成,而不是名词与动词的简单组合。例如,“清理餐桌”包括将不同餐具、杯子和器具放入收纳箱,并将垃圾物品投入垃圾桶。
- 任务长度重采样: 将每个任务–机器人组合按 $n^{0.43}$ 加权,其中 $n$ 是该组合的样本数量,使过度表示的组合自动降低权重。
- 后训练数据: 不同任务需要的训练量差异很大:最简单的任务仅需 5 小时数据,复杂任务则可能使用 100 多小时。每条数据同样包含任务名称和分段标注,推理时由上层 VLM 提供子任务标签。
$\pi_{0.5}$
- 要实现泛化,需要从多种信息源迁移经验和知识,将不同模态纳入同一序列建模框架,统一训练机器人数据、语言数据、计算机视觉数据及其组合。论文声称模型可以在未见过的家庭环境中完成任务,并特别强调数据来源的多样性,例如从网络数据构建图像描述、问答和物体定位样本。
- 泛化的新标准应当是多任务、多场景、单模型与高成功率。
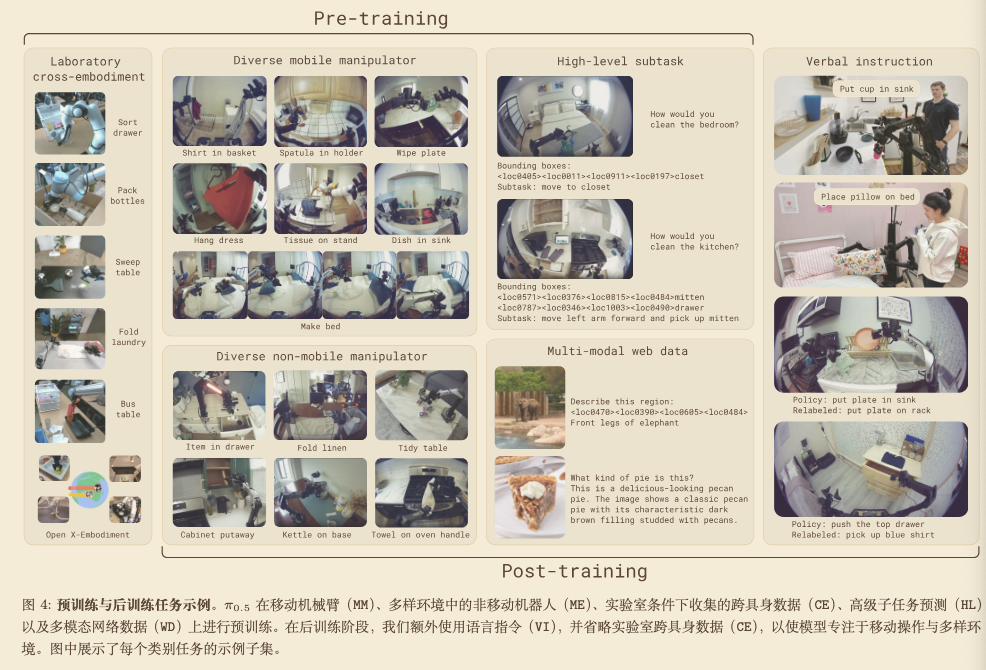
- 多样化的移动机械臂数据:400 小时以上、覆盖 100 个不同环境。
- 多样环境中的非移动机器人数据(ME)。
- Cross-Embodiment 实验室数据(CE)。
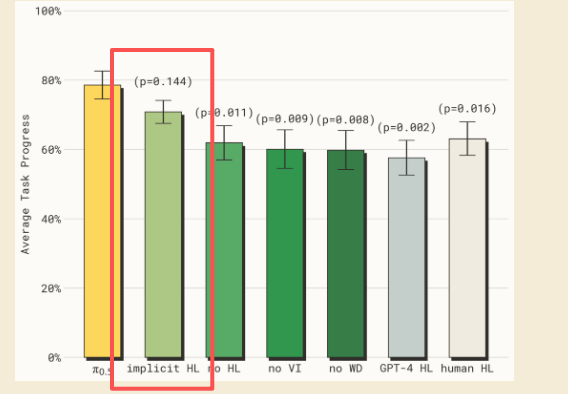
- High-Level subtask prediction(HL)。 将高层任务指令(如“打扫卧室”)分解为更短的子任务(如“整理毯子”和“拾起枕头”),类似于语言模型的思维链提示,帮助策略理解当前场景并确定下一步动作。
- 基于当前观察和高层指令,联合预测子任务标签与动作。
- 标注当前观察中出现的相关边界框,并训练 π₀.₅ 在预测子任务之前先预测这些边界框,让模型学会关注正确的位置。
- 多模态网络数据(WD): 纳入多样化的网络数据,涵盖图像描述(CapsFusion [87]、COCO [12])、问答系统(Cambrian-7M [77]、PixMo [19]、VQAv2 [32])以及预训练中的物体定位。
2. 模型架构
下面从模型架构出发,对 π₀ 与 π₀.₅ 进行比较。
$\pi_0$
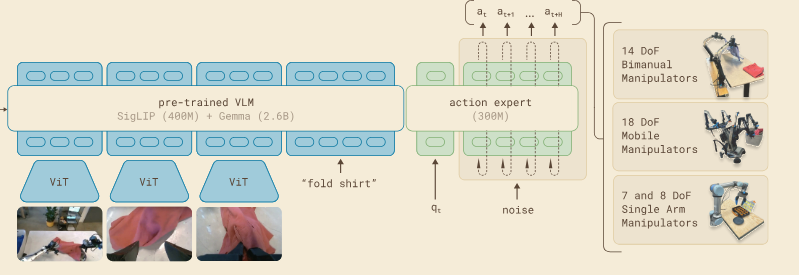
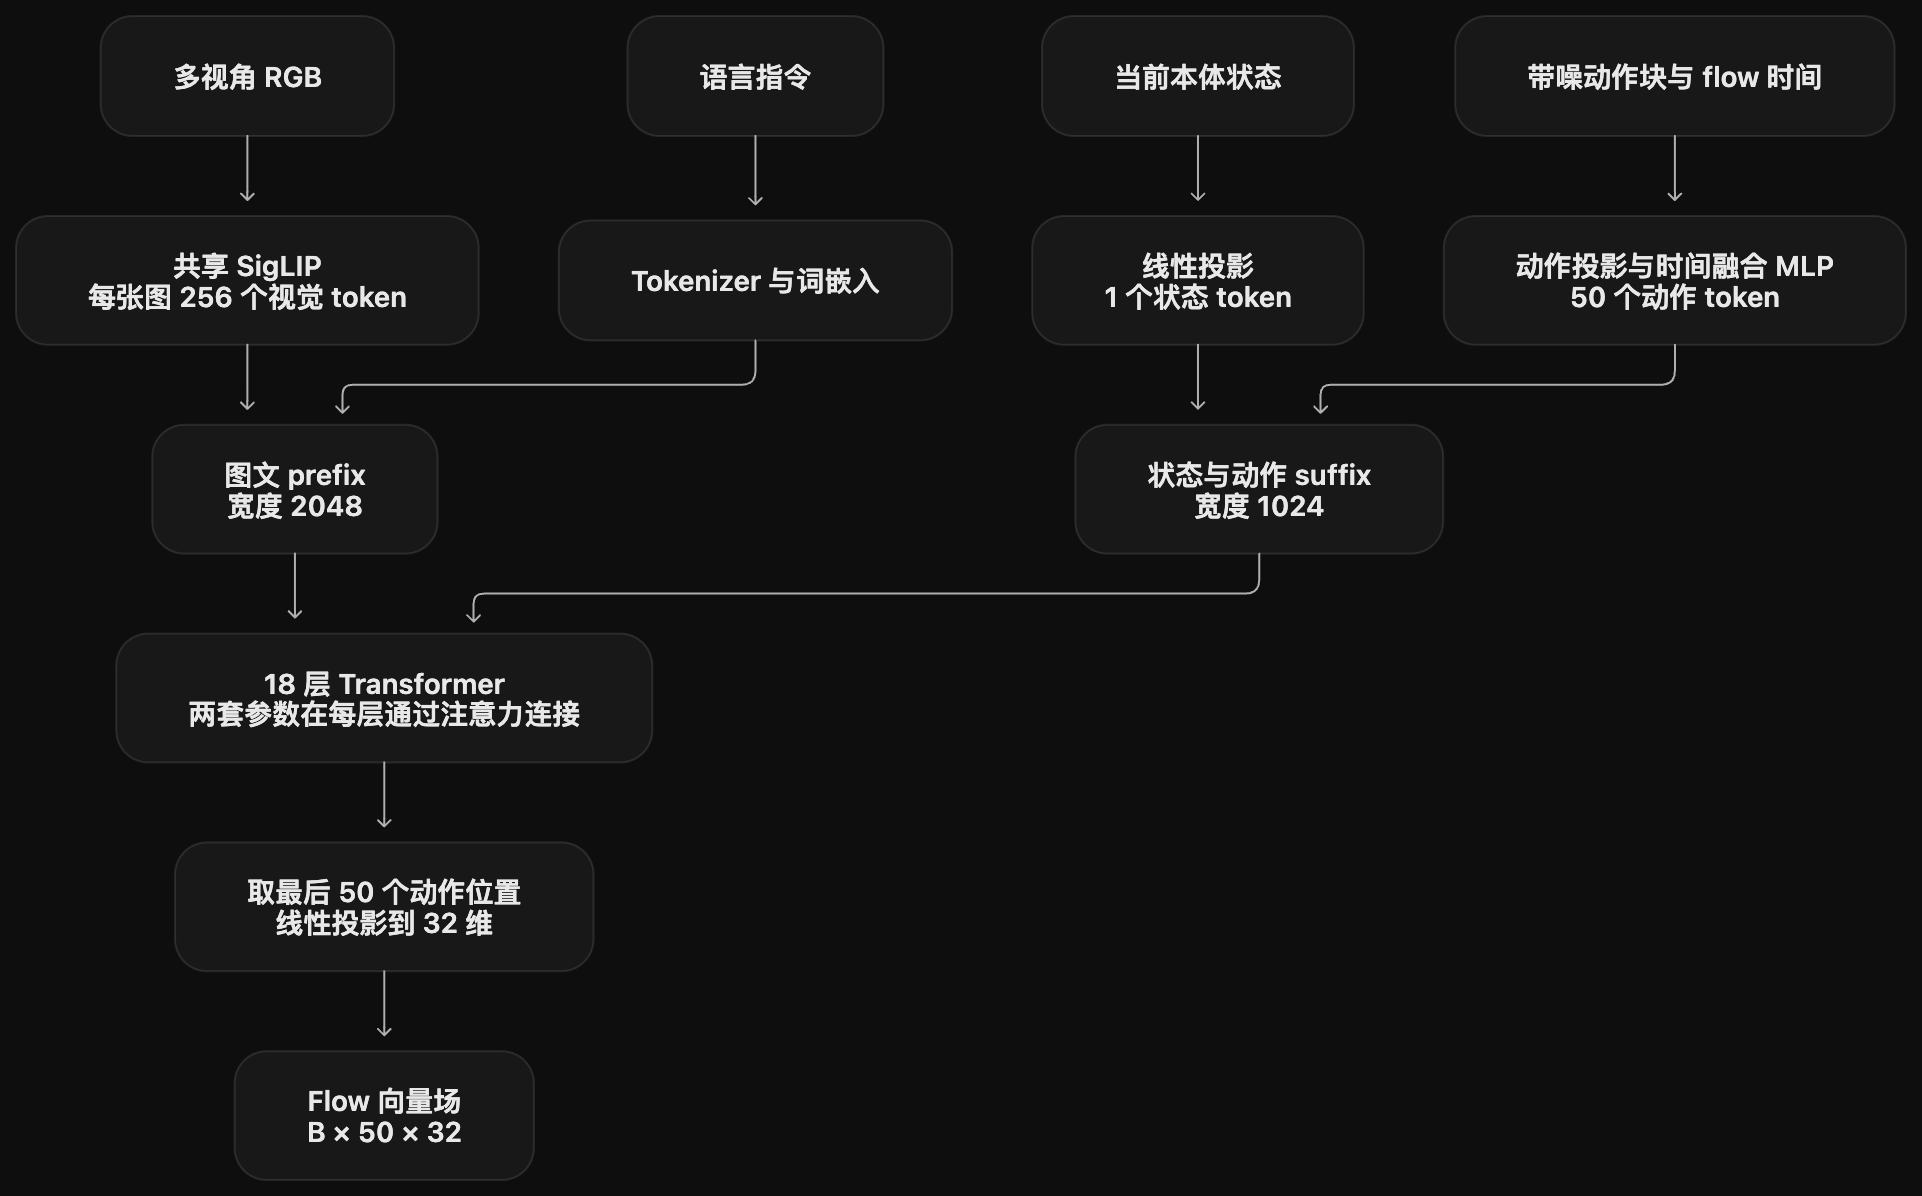
图像和语言
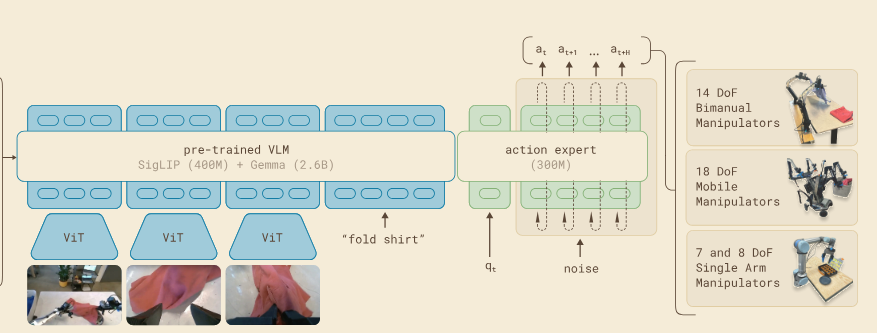
头部+2个腕部相机拢共3个相机视角,默认分辨率是224*224,然后如果没有第三路相机就用黑图占位,然后编码器用SigLIP So400m, 编码成256个token,各个相机共用编码器但是独立编码,最后再concate到一起,变成768个token,然后对于黑图就mask掉对应的token.
具体而言就是224 * 224按14 *14的patch划分成256个patch,用stride=14的卷积来提取,输出通道1152,接着展平成256个token(dim=1152),最后27层SigLIP编码成dim=2048 . \([B,256*3,2048]\) 这里是因为SigLIP 是PaliGemma的视觉encoder,直接就搬过来用了,现在常用的还有Qwen3-VL-4B-Instruct,Qwen3.5-4B,Qwen3.5-2B,Cosmos-Reason2-2B,这里选用的一个标准就是要使用方便,而且规模相对较小,适合实时控制,所以理论上我们希望能够在不增加控制延迟上选用更强的VLM, 因为往往具备更强的语言理解,更好的视觉语义和grounding,甚至是更好的空间与关系表征。
language 先添加 BOS,来标记序列开头和区分句子边界,然后用PaliGemma的tokenizer进行编码编码,末尾追加单独编码的换行标记,然后 padding 或截断到配置长度,最后生成有效 token mask,维度也是2048和视觉模块对齐. \([B,48,2048]\)
最后把这三个concat起来得到输入$[B,816,2048]$
本体动作
将机器人的本体关节按照具体顺序:左臂,夹爪,右臂,右夹爪来进行排序,
统计数据集中机器人状态和动作每个关节的取值分布得到均值和标准差
用训练的统计量进行z-score归一化来消除不同关节输出量纲的影响,不同关节的数值取值范围差很大,不好直接给模型 \(\tilde{s}_d = \frac{s_d-\mu_d}{\sigma_d+10^{-6}}\)
将维度固定为最大的机器人配置维度,如果1. 排序后的关节填不满就补0,这里补到32维
- PS: 固定成 32 维,不意味着所有机器人的每个位置含义都一样,因此,使用某个机器人配置时,要保持字段顺序、数值约定和归一化统计量与训练时一致
采样噪声步$\tau$ \(u\sim\mathrm{Beta}(1.5,1),\tau=0.999u+0.001\)
接着经过一个MLP(带bias)把32维映射成一个1024维的token,同时初始化一个带噪声动作块,包含50个动作,每个动作也是32维的本体状态来表示,映射后变成50个token,
- 将时间步 $\tau$ 编码成正弦余弦向量,注入动作 token,让模型知道当前的 flow 时间步:
具体来说,对 batch 中的每个标量 $\tau_b$,先固定 512 个不同的周期。这些周期按对数间隔从 $0.004$ 到 $4.0$:
\[p_j = 0.004\times1000^{\frac{j}{511}}, \qquad j=0,1,\ldots,511.\]然后计算每个周期对应的角度:
\[\theta_{b,j}=\frac{2\pi\tau_b}{p_j}.\]对这些角度分别取正弦和余弦,最后拼成一个 1024 维向量:
\[\begin{aligned} e_{\tau_b}=\big[\;&\sin\theta_{b,0},\ldots,\sin\theta_{b,511},\\ &\cos\theta_{b,0},\ldots,\cos\theta_{b,511}\;\big]. \end{aligned}\]因此,一个时间标量会变成“512 个正弦值 + 512 个余弦值”的 1024 维向量;对 batch 中的 $B$ 条样本堆叠后得到:
\[e_\tau\in\mathbb{R}^{B\times1024}.\]不同周期让这些分量对时间变化呈现不同快慢的响应,供后面的网络使用;这一步完全由固定公式计算,没有可学习参数。
再复制到 50 个动作位置:
\[[B,1024]\rightarrow[B,50,1024].\]随后,动作 embedding 和时间 embedding 沿特征维拼接:
\[[B,50,1024]+[B,50,1024] \rightarrow [B,50,2048].\]最后通过两层 MLP:
\[z_{a,i} = W_3\, \operatorname{SiLU} \left( W_2 \left[ W_1x_{\tau,i};e_\tau \right] +b_2 \right) +b_3.\]得到:
\[z_a\in\mathbb{R}^{B\times50\times1024}.\]模型注意力
现在文本,语言,本体,噪声全都到了同个空间中来了,接下来分为两个分支
| 项目 | 图文分支 gemma_2b | 动作分支 gemma_300m |
|---|---|---|
| Transformer 层数 | 18 | 18 |
| Hidden width | 2048 | 1024 |
| MLP 中间维度 | 16384 | 4096 |
| Query 头数 | 8 | 8 |
| Key/Value 头数 | 1 | 1 |
| 每个 attention head 的维度 | 256 | 256 |
两条分支拥有各自的:
- RMSNorm;
- Q、K、V 投影;
- Attention 输出投影;
- MLP。
视觉语言分支的投影矩阵为:
\[W_Q^P\in\mathbb{R}^{2048\times2048}, \qquad W_K^P,W_V^P\in\mathbb{R}^{2048\times256}.\]动作分支的投影矩阵为:
\[W_Q^S\in\mathbb{R}^{1024\times2048}, \qquad W_K^S,W_V^S\in\mathbb{R}^{1024\times256}.\]因此,两条分支投影后的张量形状为:
\[Q_P\in\mathbb{R}^{B\times N_P\times8\times256}, \qquad Q_S\in\mathbb{R}^{B\times N_S\times8\times256}.\] \[K_P,V_P\in\mathbb{R}^{B\times N_P\times1\times256}, \qquad K_S,V_S\in\mathbb{R}^{B\times N_S\times1\times256}.\]其中 prefix 和 suffix 的 token 数为:
\[N_P=3\times256+48=816, \qquad N_S=51.\]动作分支虽然输入只有 1024 维,也会先生成总计 2048 维的 Q,再按 $8\times256$ 组织成多头;完成注意力计算后,两条分支各自用输出投影,将结果映射回 2048 维和 1024 维。
q = q.permute(0, 2, 1, 3)  # [B, 8, N, 256]
k = k.permute(0, 2, 1, 3)  # [B, 1, N, 256]
v = v.permute(0, 2, 1, 3)  # [B, 1, N, 256]

scores = (q @ k.transpose(-2, -1)) / (256 ** 0.5)
# [B,8,N,256] @ [B,1,256,N]
# → [B,8,N,N]
接着按 token 维度拼接两条分支:
\[Q=\operatorname{Concat}_{\text{sequence}}(Q_P,Q_S),\] \[K=\operatorname{Concat}_{\text{sequence}}(K_P,K_S),\] \[V=\operatorname{Concat}_{\text{sequence}}(V_P,V_S).\]Q 和 K 还会加入 RoPE 位置编码,然后计算:
\[Y= \operatorname{softmax} \left( \frac{QK^\top}{\sqrt{256}}+M \right)V,\]其中 $M$ 是注意力 mask,分成三个块:图像与语言、当前状态、整个带噪动作块。
| Query \ Key/Value | 图像与语言 | 当前状态 | 全部动作 token |
|---|---|---|---|
| 图像与语言 | ✓ | — | — |
| 当前状态 | ✓ | ✓ | — |
| 任意动作 token | ✓ | ✓ | ✓ |
具体构造就是对于 (N) 个 token 构造一个块起始标记。比如对于 2 个 prefix token、1 个状态 token、3 个动作 token,序列为
$[p_0,\ p_1,\ s,\ a_0,\ a_1,\ a_2]$。
构造一个 0、1 序列,在切换处标为 1:
ar_mask = [0, 0, 1, 1, 0, 0]
然后累加得到块编号
block_id = [0, 0, 1, 2, 2, 2]
然后构造
cumsum = jnp.cumsum(mask_ar, axis=1)
attn_mask = cumsum[:, None, :] <= cumsum[:, :, None]
也就是,只能看到比自己小的部分得到
| Query ↓ / Key → | $p_0$ | $p_1$ | $s$ | $a_0$ | $a_1$ | $a_2$ |
|---|---|---|---|---|---|---|
| $p_0$ | 1 | 1 | 0 | 0 | 0 | 0 |
| $p_1$ | 1 | 1 | 0 | 0 | 0 | 0 |
| $s$ | 1 | 1 | 1 | 0 | 0 | 0 |
| $a_0$ | 1 | 1 | 1 | 1 | 1 | 1 |
| $a_1$ | 1 | 1 | 1 | 1 | 1 | 1 |
| $a_2$ | 1 | 1 | 1 | 1 | 1 | 1 |
mask 为 1 时保留原分数;mask 为 0 时,将原分数替换成极大的负数,使 softmax 后对应位置的权重变为 0。
然后输出仍然保留所有 token 的位置。模型按照 prefix、suffix 的序列范围切开结果,再应用各自的输出投影:
\[Y_P \rightarrow [B,N_P,2048], \qquad Y_S \rightarrow [B,N_S,1024].\]一个 block 结束后,两条分支分别进行残差连接和 MLP 更新:
\[\begin{aligned} h' &= h+\operatorname{AttentionOutput}(h),\\ h_{\text{next}} &= h'+\operatorname{MLP}\left(\operatorname{RMSNorm}(h')\right). \end{aligned}\]MLP 使用门控形式,可以概括为:
\[\operatorname{MLP}(x) = \left[\operatorname{GELU}(xW_g)\odot(xW_u)\right]W_d.\]图文分支的 MLP 中间维度为 16384,动作分支为 4096。
损失计算
取 suffix 的最后 $H$ 个位置,即动作 token,经过输出投影:
\[[B,H,1024] \rightarrow [B,H,32],\]得到动作速度预测:
\[\hat{v}_\tau=v_\theta(X_\tau,o,\tau).\]流匹配损失为:
\[\begin{aligned} \mathcal{L} &=\mathbb{E}_{o,A,\epsilon,\tau}\Bigg[ \frac{1}{HD}\sum_{i=1}^{H}\sum_{j=1}^{D}\\ &\qquad\left( v_\theta(X_\tau,o,\tau)_{i,j}-(\epsilon-A)_{i,j} \right)^2 \Bigg]. \end{aligned}\]推理时默认使用 10 次欧拉积分,步长为:
\[\Delta\tau=-\frac{1}{N}=-0.1.\]带噪动作块从标准高斯分布采样,每一步按照下面的公式更新:
\[X_{\tau+\Delta\tau}=X_\tau+\Delta\tau\,v_\theta(X_\tau,o_k,\tau).\]同一个动作块的 10 次 flow 迭代中,图像、语言和当前状态保持不变,只有带噪动作与 flow 时间持续变化。又因为 prefix 不读取 suffix,所以各层的 prefix K/V 与带噪动作无关,可以预先计算并缓存。实际执行顺序是:编码图像与语言;执行一次 prefix 前向;缓存每一层的 prefix K/V;然后在每次 flow 迭代中运行动作分支并读取这些缓存。
训练细节
- 本体状态向量 $q_t$ 和动作向量 $a_t$ 总是具有数据集中最大机器人( 18,两个 6 自由度手臂、2 个夹爪、一个移动基座(x,y,yaw)和一个垂直可动躯干)的维度。
- 本体状态空间和动作空间维度较低的机器人,我们对配置和动作向量进行零填充
- 对于图像数量少于三张的机器人,屏蔽掉缺失的图像槽位。
实验 insight
- 从较大的预训练 VLM 初始化有利于模型在高级指导下的复杂任务上更好的自主性能。
- 微调评测的时候,预训练见过的类似任务的任务和预训练完全没见过的任务的难度是截然不同的,如果只在预训练见过的任务或者类似任务评测是不合理的。
$\pi_{0.5}$
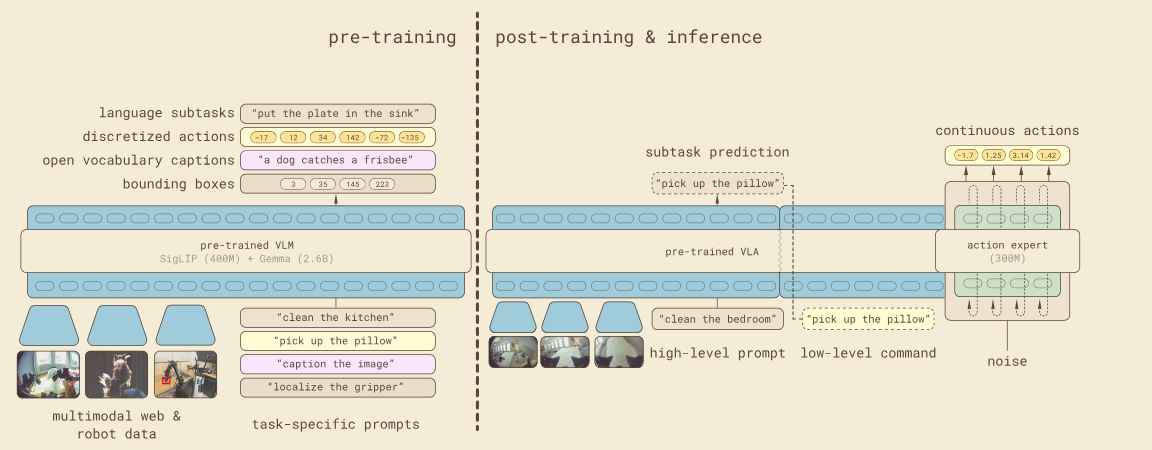
π₀.₅ 相较于 π₀ 的架构改进主要体现在三点:
- 采用分层架构。 π₀ 使用 PaliGemma 与动作头联合训练;π₀.₅ 则改为两阶段训练:
- 首先继续预训练 PaliGemma,使 VLM 适应多样化的机器人任务。
- 随后专注于移动操作任务,并配备高效的实时推理机制。
- 引入子任务指令。
- 改进动作编码。 π₀ 使用 MLP 将 32 维动作 token 映射到 1024 维;π₀.₅ 则采用更先进的 FAST action tokenizer。
下面从代码层面进一步梳理 π₀ 与 π₀.₅ 的具体差异。
1. 本体状态通过文本形式进入 VLM
在 π₀ 中,本体状态通过 MLP 从 32 维投影到 1024 维;π₀.₅ 则沿用了 FAST 风格的 tokenizer。
首先归一化不再是直接计算均值和方差,而是改成分位数归一化,主要是为了让大部分数据落到 $[-1,1]$ 范围内。对第 $d$ 个状态分量,可以写成:
\[\tilde s_d = 2\frac{s_d-q_{0.01,d}} {q_{0.99,d}-q_{0.01,d}+10^{-6}} -1\]这样可以为后续离散成 256 档做准备,因为每个状态维度都需要单独分箱。
discretized_state = np.digitize(
    state,
    bins=np.linspace(-1, 1, 257)[:-1],
) - 1
从而把每一个关节分量转成对应的分箱编号:
\[[-0.5,\ 0,\ 0.5] \quad\longrightarrow\quad [64,\ 128,\ 192].\]接下来把这些整数转成字符串,并与任务描述拼接:
Task: pick up the cup, State: 64 128 192;
Action:
最后,整个字符串通过 PaliGemma 的 SentencePiece tokenizer 得到文本 token。
2. 时间注入独立化:动作分支特殊处理
在 π₀ 中,动作块先通过 MLP 投影到 1024 维,去噪时间步通过正余弦编码得到 1024 维表示,随后拼接并再次经过 MLP,实现时间步与动作块的融合。
- 带噪动作块仍然通过 MLP 投影到 1024 维。
- 时间步先通过正余弦编码得到 1024 维表示,再经过带 SiLU 激活的两层 MLP,最终作为新的时间 token 传给 Transformer。
因此,最终输入由三部分组成:prefix(图文 token,2048 维)、动作块 token(1024 维)和时间 token(1024 维)。
时间步通过 AdaRMS 注入动作分支:
对于动作块当前 Transformer 层的输入,每个 token 为 1024 维;先对动作块的特征维进行 RMS 标准化:
\[r(S_l) = \frac{S_l} {\sqrt{mean_{d}(S_l^2)+10^{-6}}}.\]然后将时间 token 通过 MLP 投影成 3072 维,并切分成三个 1024 维参数:
\[[\gamma_l,\beta_l,g_l] = c_\tau W_l+b_l,\]然后对特征维进行缩放,得到最终的动作块特征:
\[\widetilde S_l = r(S_l)\odot(1+\gamma_l)+\beta_l.\]接着生成动作分支的 QKV,与感知分支拼接后进行联合 attention,并在输出时进行残差更新:
\[S'_l = S_l + g_{l,\text{attn}} \odot \Delta S_{\text{attn}}.\]接着,在 FFN 之前再做一次 AdaRMS。这一次使用另一套参数**,产生另一组缩放、偏移和 gate:
# Attention 子层
p = prefix_rmsnorm(P)
s, gate_attn = action_adarms_attn(S, time_condition)

delta_p, delta_s = joint_attention(p, s, mask)

P = P + delta_p
S = S + gate_attn * delta_s

# FFN 子层
P = P + prefix_ffn(prefix_ffn_rmsnorm(P))

s, gate_ffn = action_adarms_ffn(S, time_condition)
S = S + gate_ffn * action_ffn(s)
Attention
| Query 所在位置 \ Key 所在位置 | Prefix:图像、任务、状态 | 动作块 |
|---|---|---|
| Prefix | 可以看 | 不可以看 |
| 动作块 | 可以看 | 可以看 |
| 张量 | π₀ | π₀.₅ |
|---|---|---|
| 图像 token 槽位 | $3\times256=768$ | $3\times256=768$ |
| 文本 token 槽位 | 48 | 200 |
| Prefix | [B,816,2048] | [B,968,2048] |
| Suffix | [B,51,1024] | [B,50,1024] |
| 总 token 槽位 | 867 | 1018 |
感知分支接 Decoder 头:输出子任务以强化推理
- 用于输出子任务,损失函数采用大模型的 logit 交叉熵损失。
训练细节
- 一阶段在异构的训练任务混合数据上对模型进行预训练
- 所有任务都用离散 token 表示,并用 FAST 进行编码,从而与文本一样使用离散 token。
- 训练 28 万个梯度步。
- 二阶段专门针对移动操作任务进行微调,既使用低级动作示例,也使用高级“语义”动作;这些动作对应于预测“拿起切菜板”或“重新整理枕头”等子任务标签。
- 目标是使模型专门适用于我们的应用场景(家庭环境中的移动操作)。
- 后训练动作数据集由 MM 和 ME 机器人数据(筛选低于固定长度阈值的成功回合)、网络数据(保持模型的语义与视觉能力)以及 HL 数据(对应多环境数据集的部分)组成。
- 语言指令示范数据(VI)。
- 训练 8 万步。
- 推理时,高层模型首先预测语义子任务,根据任务结构和场景语义推断接下来适合执行的行为,然后由 VLA 基于子任务预测低级机器人动作块。
实验观察
- 一阶段预训练能显著提升场景泛化能力,而且后训练场景越多样,模型在 OOD 场景下的泛化越好。
- 增加训练数据中的环境数量后,语言跟随性能和成功率均有所提高。由于每个新环境都会引入新的家居物品,模型总体上变得更加稳健,并开始泛化到训练数据中未出现的任务类别。
- 机器人数据减少会导致性能显著下降;移除网络数据(无 WD)会显著降低模型在分布外(OOD)物体上的表现。
- FAST token 的训练在计算效率上优于纯扩散训练。
- 一个有趣的现象是,外挂模型显式提供子任务时效果反而不佳。可能的原因是指令不一致,以及大模型推理中的幻觉;从个人观察来看,直接由模型内部完成子任务推理的效果更好。
不过,目前公开的只有 π₀.₅ 的 flow-matching 分支训练与推理,因此并非完整版本,而是一个精简版。