浅谈 VLA 训练数据的动作表示
Published:
浅谈 VLA 训练数据的动作表示
在大家都关注VLA模型架构设计的现如今,训练数据的具体细节很容易被忽略,直觉上末端位姿 (end-effector pose) 应该是最接近任务语义的表示.夹爪要去哪里、转到什么朝向,一目了然。但最近在真机上部署用 pose 记录动作的策略时会经常出现两个问题
- 输出的位姿经常 IK 无解。pose 要先过一遍逆运动学再下发关节角,而模型输出的目标位姿时不时落在工作空间外或奇异点附近,求解器直接失败;
- 动作跳变太大。相邻两帧输出的位姿差得离谱,机械臂一抖一抖。
我第一反应是觉得 IK 求解器或者模型不够好。然后本人去做了一些数据层面的调研,发现了一些know-how故分享出来. 主要是围绕两篇工作展开,一个是 Demystifying Action Space Design for Robotic Manipulation Policies (arXiv:2602.23408) ,一个是 Qwen-RobotManip Technical Report (arXiv:2606.17846) 。众所周知,你在数据里用什么表示记录动作,策略就被监督去预测什么表示,部署时就以什么形式抵达硬件,也就是所谓的训推一致。前者用 13000+ 次真机 rollout、500+ 个模型把这个模型训练怎么选动作表示系统研究了一遍,后者在 38100 小时预训练、15 个本体的基础模型工程实践.
首先是熟悉的术语约定表示: 本文中
- joint space 指以各关节角度/位移为分量的动作表示
- task space 指以末端位姿 $(p,R)\in\mathbb R^3\times SO(3)$ 为分量的表示
- absolute 指每帧直接记录状态本身
- delta 指记录相对参考状态的增量
- 其中每帧都以上一帧预测为基准的叫 step-wise delta
- 整段动作以同一个基准状态计算增量的叫 chunk-wise delta。
- EE pose 泛指末端位姿(PS : 实际数据里要分清记的是 End Link(法兰中心)还是 TCP(工具中心点),两者通常差一个固定变换。)
然后本文也主要沿着这两篇论文的逻辑主线走
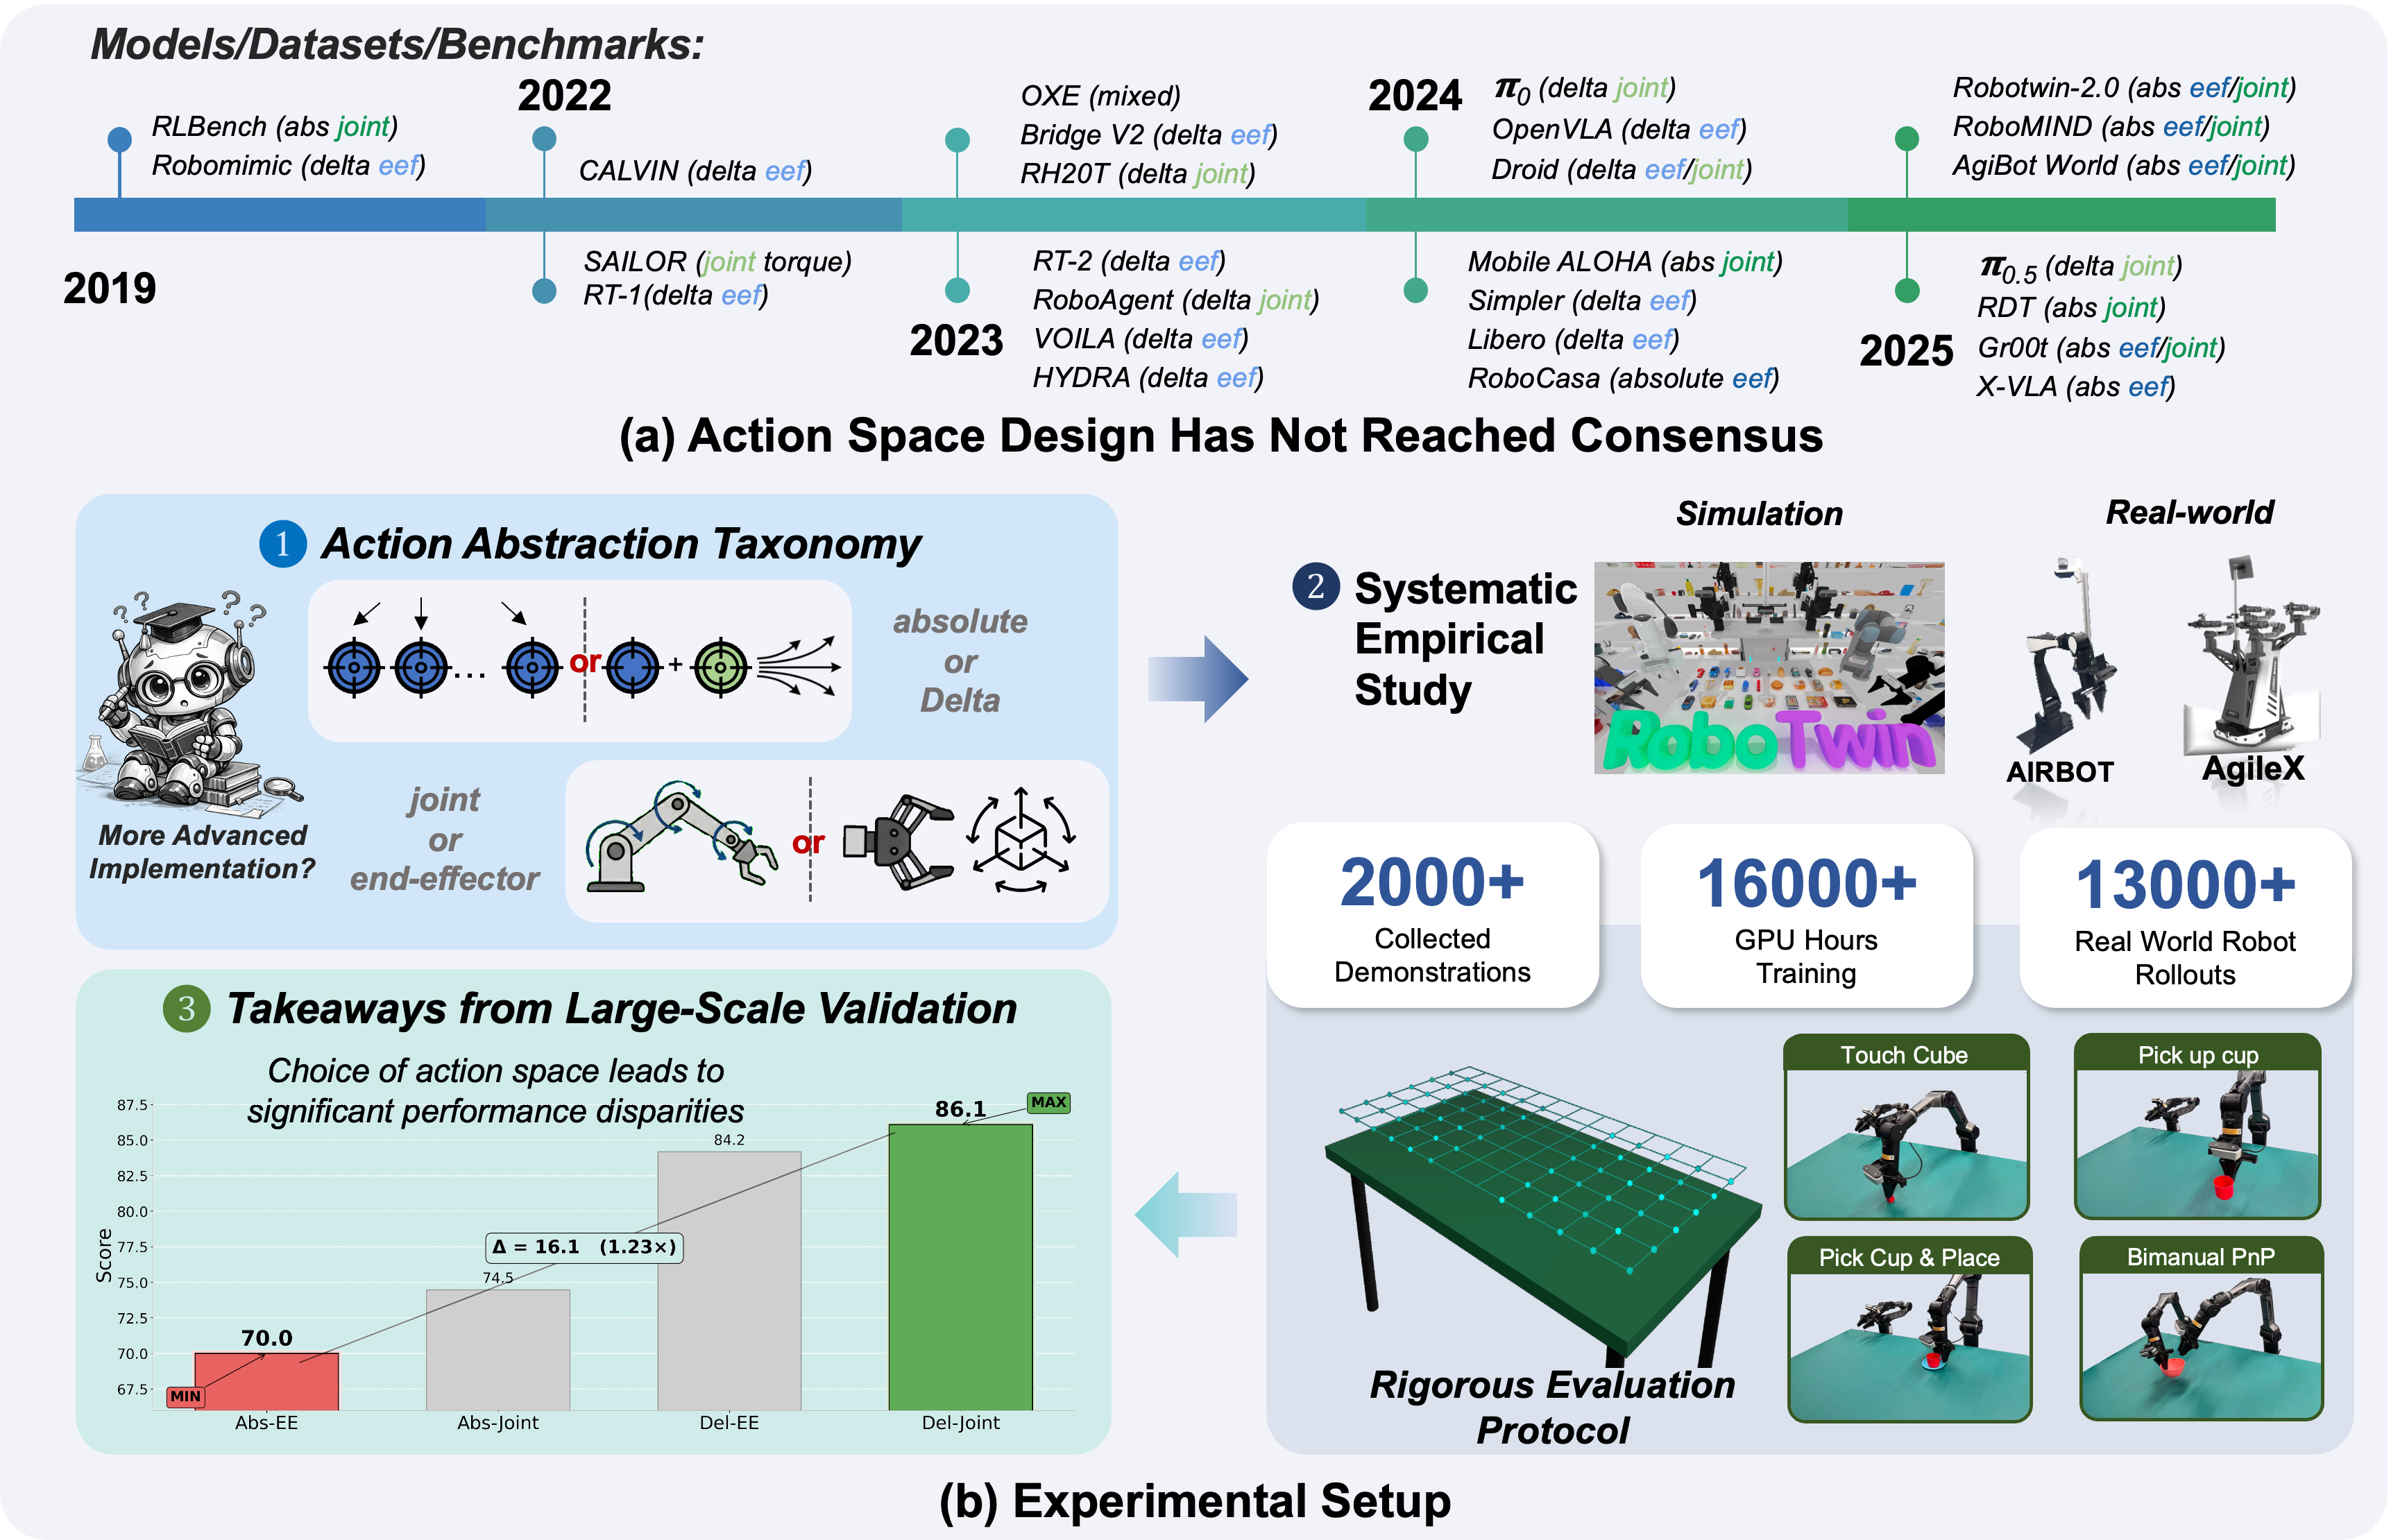
图 1:(a) 时间线显示动作空间设计从未达成共识,π₀ 与 OpenVLA 用 delta,Mobile ALOHA 与 RDT 用 absolute,Gr00t 甚至在同一模型里混用;(b) 作者据此构建了 2000+ 演示、13000+ 真机 rollout 的大规模实证,仅换动作空间就能带来 70.0 → 86.1(1.23 倍)的差距。
1. 动作表示的本质: 三维设计空间
现有的机器人数据集,动作的记录方式基本落在下面两类里。
关节角 (joint angles):直接记录每个关节的旋转/平移位置。要么存绝对值,每一帧都是独立的 $J_1=30°,\;J_2=-15°,\ldots$;要么存相对第一帧(或当前帧)的增量, 天然无奇异、无多解。
末端位姿 (end-effector pose):记录末端在空间中的位置和朝向。这一类就有很多种选法
旋转用什么表示:四元数(4 维,无万向锁,插值平滑)、旋转矩阵(9 维,冗余但计算方便)、RPY(3 维,直观但有万向锁);
绝对位姿还是增量位姿;
记在哪个坐标系、哪个参考点(End Link(法兰中心)/ TCP(工具中心点))
所以经常大家都会问是关节角好还是末端位姿好呢? 实际上第一篇论文中作者的答案是这些选项是三个正交的维度,前两个是主轴。
- 空间轴 (spatial abstraction):关节角 or 末端位姿。
- 时间轴 (temporal abstraction):每一帧存状态本身,还是相对参考状态的增量。
两个轴自由组合,得到 joint-abs、joint-delta、task-abs、task-delta 四种基本形态,而平时争论的关节角 vs 末端位姿只是其中空间轴的那一半:
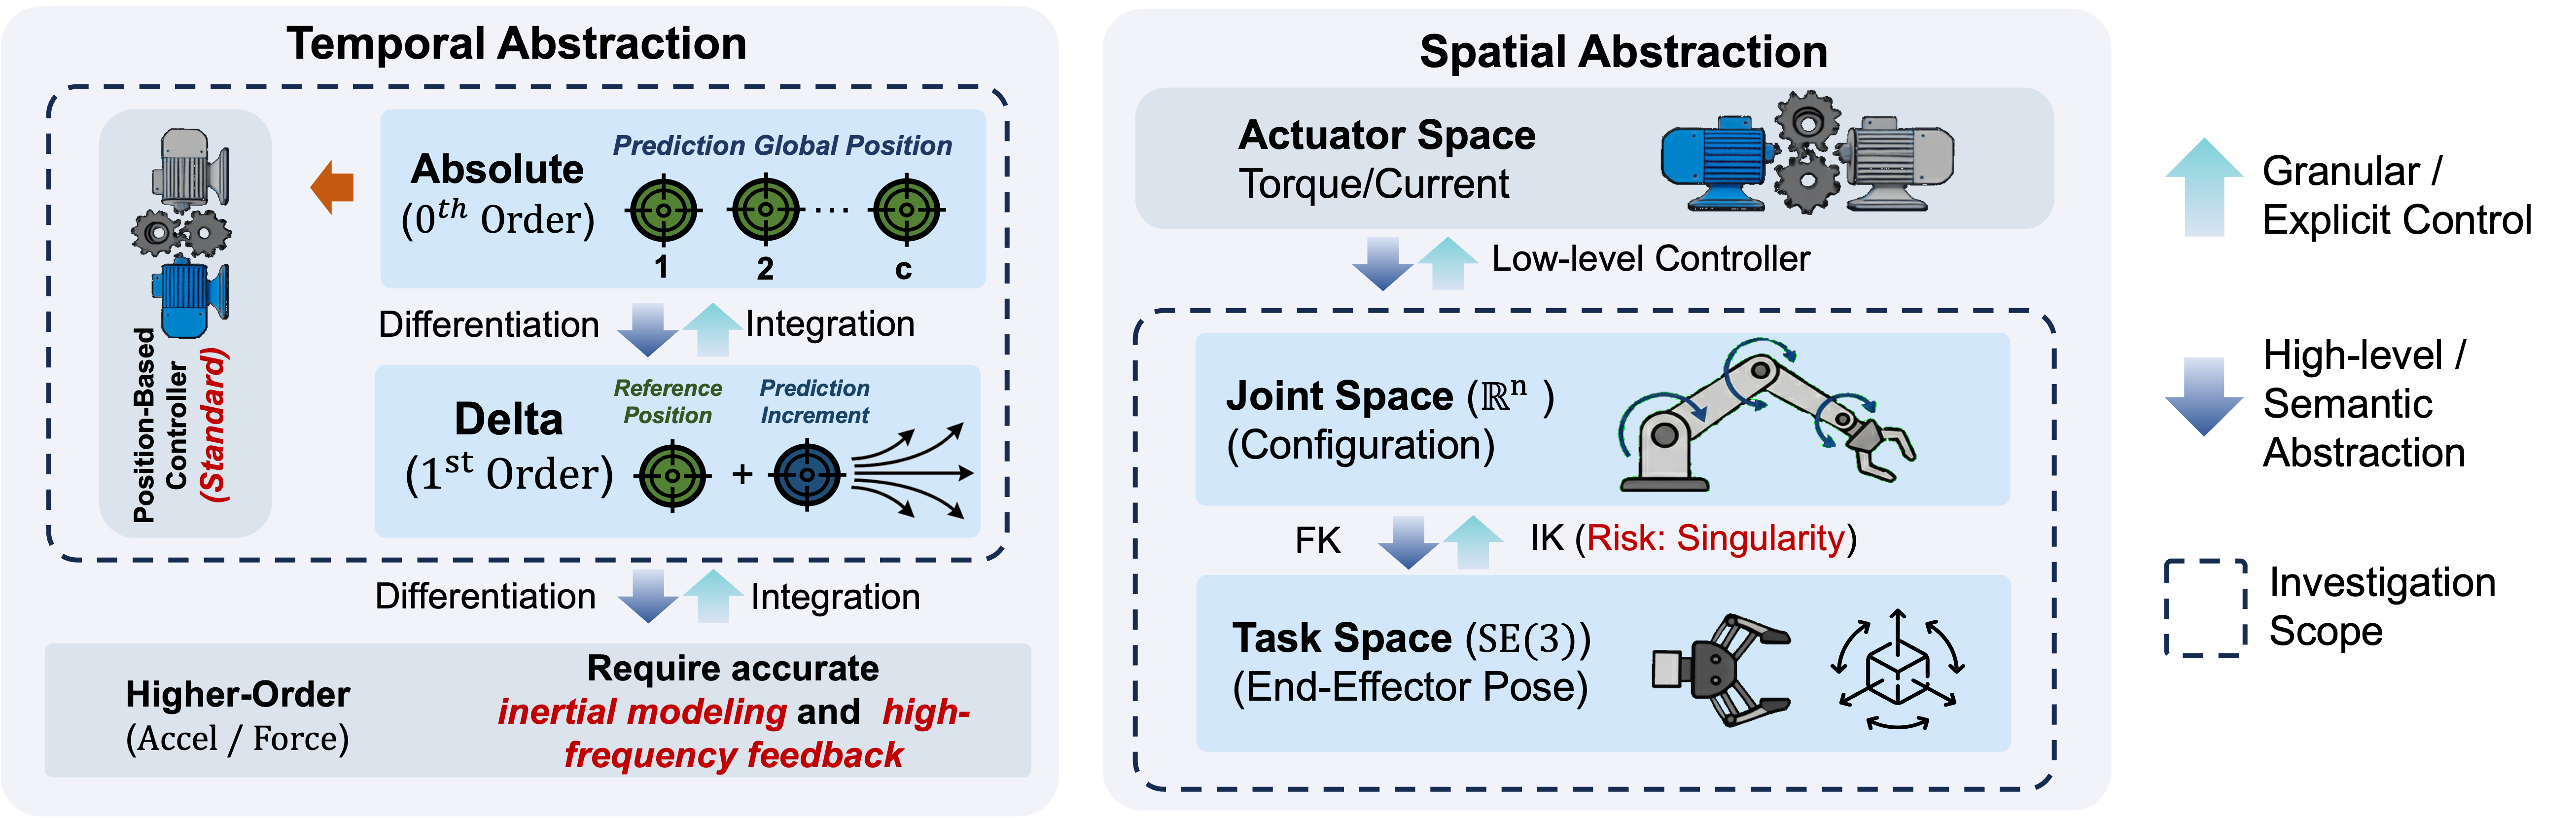
第三个维度藏在 task space 内部:旋转表示(四元数 / 旋转矩阵 / RPY / 6D)与参考系(基座系还是相机系、End Link 还是 TCP),其中旋转表示决定了预测输出的连续性, 参考系决定不同来源的数据能不能对齐。
那么问题来了, 时间轴上怎么选?空间轴上怎么选?
2. 时间轴:delta > Absolute
时间轴回答的问题是:数据里每一帧该存状态本身还是状态的变化量。整篇论文的结论是:delta 一致且显著地优于 absolute,跨平台、跨任务、跨模型结构全部成立。研究总览图里的那组数字(70.0 → 86.1)就是四种形态在真机上的总排序:absolute-EE 最差,delta-joint 最好;RoboTwin 2.0 上 DP 的 joint 动作同样从 absolute 的 32.3 提升到 delta 的 48.0。
但为什么?
第一层,absolute 要求网络内化全局几何。这个数本身没有意义,模型必须同时学会工作空间的形状、每个位形在空间中的位置,等于把定位问题也压给了动作头。而 delta 是一个局部、平移不变的目标,「往右移 2 cm」不需要知道工作空间长什么样。
第二层,delta 是更好的 inductive bias。学习目标从命中空间中一个点变成预测一个局部变化,其实有点残差网络那味,优化 landscape 整个变简单了。这也是为什么 delta 的优势在低数据量、低算力时最明。
故事到这里还没完。delta 内部还藏着一次分化,而且这次分化直接关系到开头的第二个坑。逐帧 (step-wise) 生成 delta(每帧都以上一帧的预测为基准算增量, 会让预测噪声逐步级联:每一步都叠一个 $\pm\delta$ 的误差,$k$ 步之后的误差界以
\[O(k)\approx\frac{2k+1}{\pi}\,\delta\]线性增长;而 chunk-wise delta, 一次预测一整段、整段以同一个基准状态计算增量,和 absolute 的误差界都是常数 $O(1)$。真机上 chunk-wise 平均比 step-wise 高出 10% 以上。
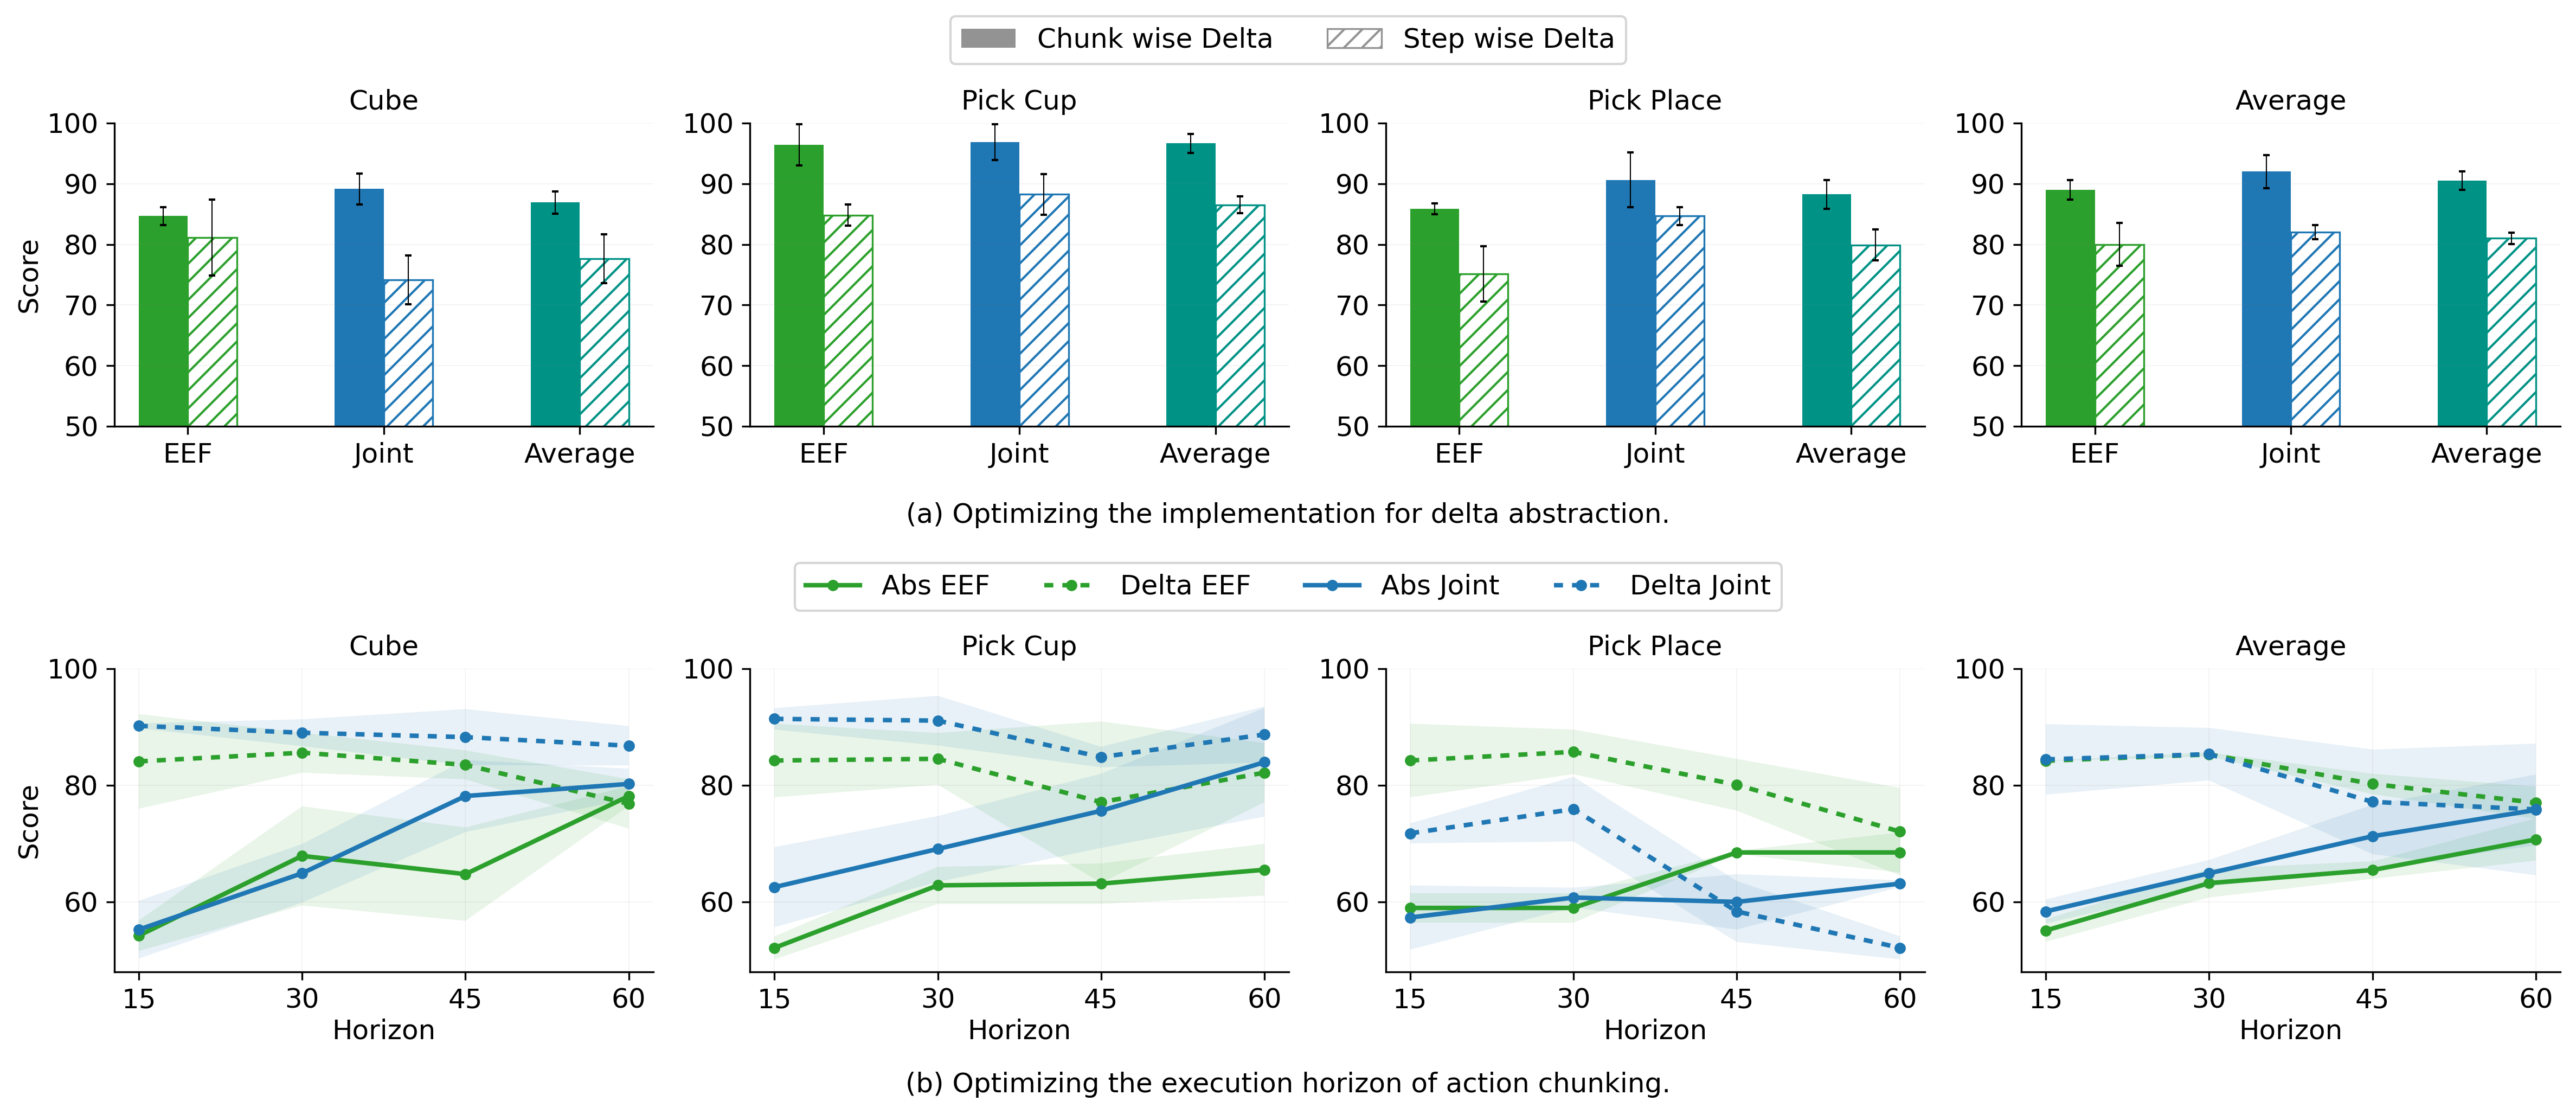
图 3:(a) EEF 与 Joint 两种空间下,chunk-wise delta(实心柱)全面高于 step-wise delta(斜纹柱);(b) 执行 horizon 网格搜索:delta 动作在 $k=30$ 附近达到峰值,而 absolute 要到 $k=60$(30Hz 下约 2 秒)才接近收敛——时间抽象与 chunk 长度是耦合的。
图 3(b) 还藏着一个经常被忽略的耦合:delta 还是 absolute 的选择会改变最优 chunk 长度。delta 的漂移会累积,所以需要更频繁地重新观测来归零,最优 horizon 更短;absolute 没有漂移问题,反而受益于更长的执行段。那么下一个问题自然浮现:空间轴上是不是也存在这样一个默认答案?
3. 空间轴:joint 利稳,task 利泛,但代价不对称
空间轴回答的问题是:数据里记录关节角还是末端位姿。这个轴上没有一边倒的赢家。2602.23408 的说法是 “complementary strengths”,但我觉得更准确的理解是:两个表示各自对应一种学习机制,赢在完全不同的地方。
joint space 赢在稳定场景下的学习效率,更适合后训练在数据充足、算力充足的单平台模仿学习里,joint 动作更稳健;而且随着数据量(100/250/500 条演示)和训练轮数(300→1200 epochs)增加,joint 表示的收益 disproportionate 地增长,尤其对回归类策略。论文的表述是 joint 表示本质上更适合捕捉底层运动学流形,毕竟真机数据本来就是在关节空间里产生的,而EE pose 是经 FK 投影出来的二次量,学原始量当然比学投影量更顺。
task space 赢在泛化场景,更适合预训练。在跨本体训练和迁移学习里,EE pose 经常反超 joint space,原因很有意思:两台不同机械臂的关节空间毫无交集,但末端往右移 5cm在 task space 里对任何机器人都是同一个概念。task space 具有相对的本体不变性,这种不变性在单机任务里毫无用处,在跨本体场景里却是救命稻草。
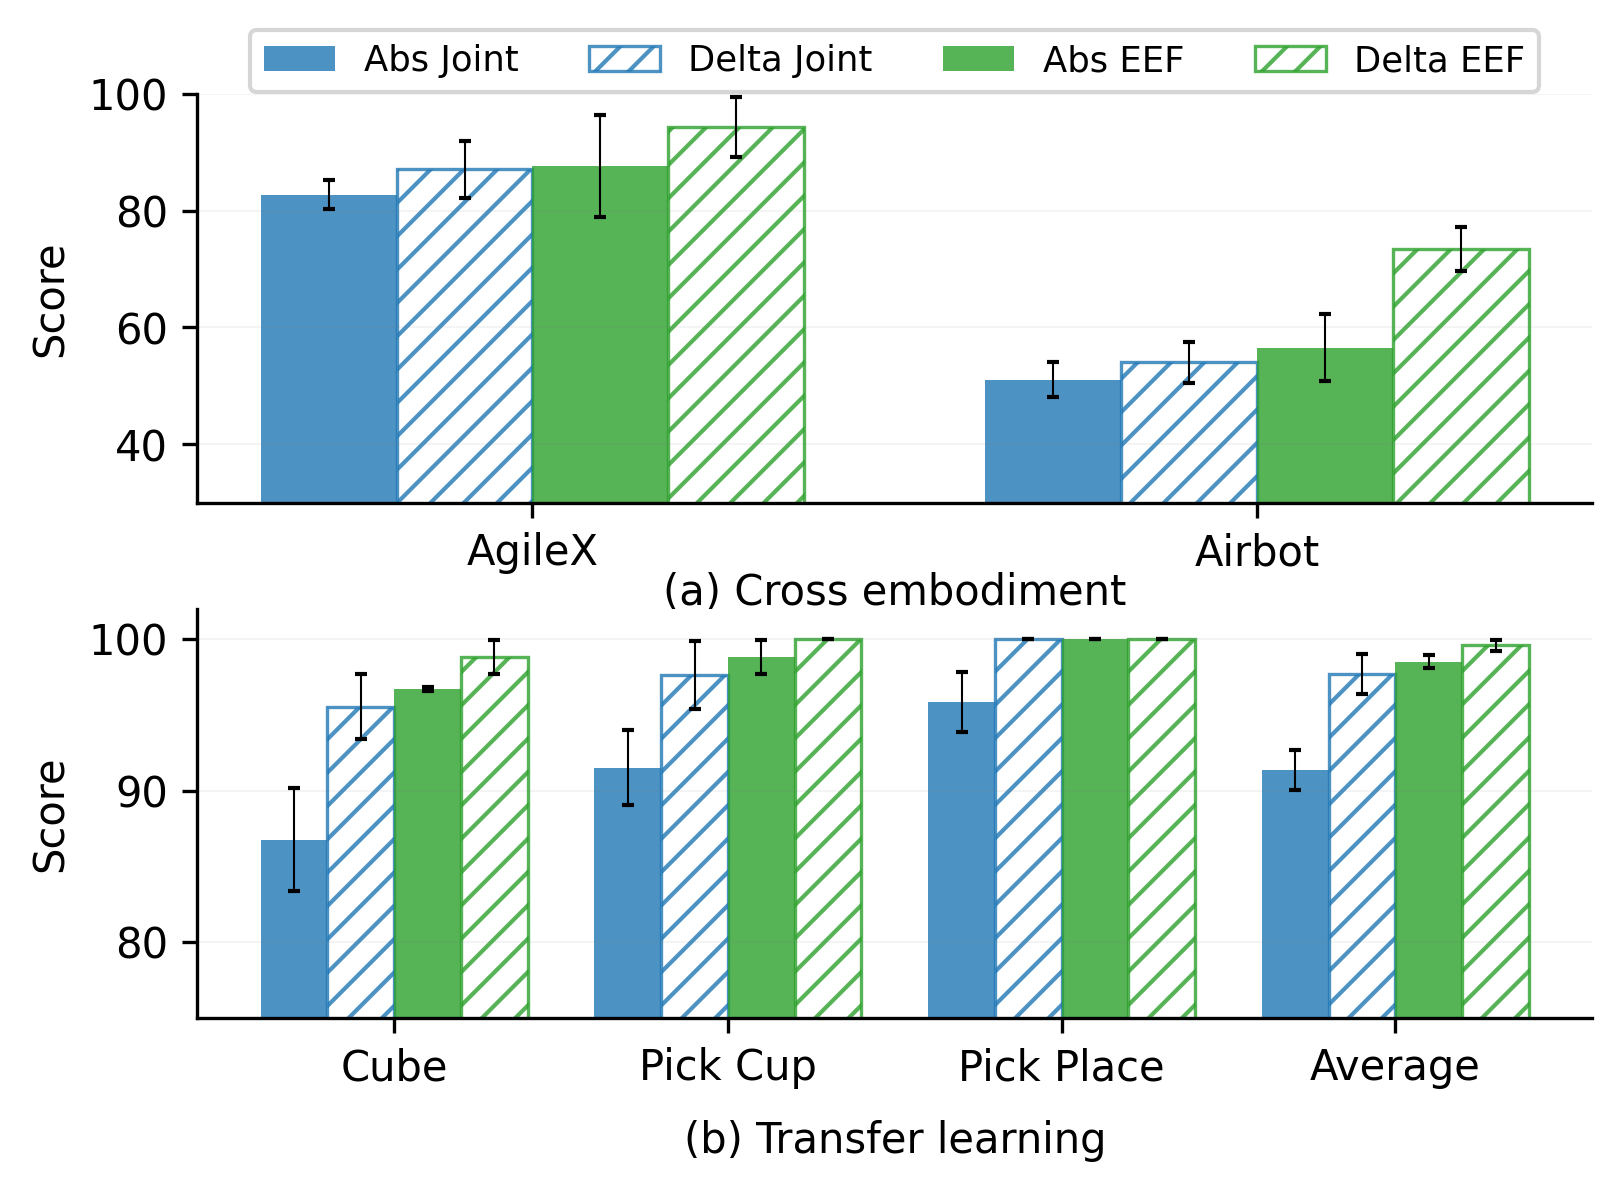
图 4:(a) 跨本体设置下,Delta EEF 在 AgileX(94.5)和 Airbot(73.5)上都显著领先 Delta Joint;(b) 迁移学习(π₀ 微调)中 Delta EEF 同样全面最优。task space 的本体不变性在这两个场景里兑现成了实打实的成功率。
但这只是学习侧, task space 还有一笔部署侧的账:选了 EE pose 就意味着部署链路里必须插入一个 IK 求解器。论文在正文里专门点名这件事, task-space 控制在部署时依赖 IK 求解器,引入数值奇异性和误差累积,降低执行鲁棒性。
4. 回头看那两个坑:根源都在动作表示的设计里
4.1 坑一:IK 无解
用绝对位姿当动作输出时,每一步执行都要经过:
\[\text{VLA} \rightarrow p_t,R_t \xrightarrow{\text{全局 IK}} q_t \rightarrow \text{下发}.\]全局 IK 的输入是空间中一个孤立的点。模型输出的 $p_t,R_t$ 完全可能落在可达工作空间之外、奇异点附近,或者落在解析解的多解分支之间, 即使这次有解,下次求解也可能跳到另一个分支。所以组合的优劣性如下
第一级,task-abs(现状):全局 IK,目标可能无解、多解、分支跳变——最差的组合。
第二级,task-delta:把时间轴从 absolute 换成 delta。目标永远在当前状态附近,全局 IK 退化成阻尼最小二乘的微分 IK($J^\top(JJ^\top+\lambda I)^{-1}$ 迭代一两步),局部几乎总有解。注意这一步什么新东西都没加,纯粹是把第 2 节「delta 全面胜出」的结论在部署侧重新兑现了一遍。
第三级,joint-delta:IK 环节整个消失,输出即可执行。这就是为什么 π₀ 这类新一代模型纷纷转向 joint space。
4.2 坑二:跳变
来源一:step-wise delta 的噪声级联。如果动作逐帧生成、每帧都以上一帧预测为基准,第 2 节的 $O(k)$ 级联在宏观上就是高频抖动。修法:chunk-wise delta,一次预测一整段。
来源二:旋转表示的不连续。这是我觉得三个来源里最值得展开的一个,因为它和模型能力完全无关,纯粹是表示的数学性质:
- 四元数有双覆盖问题:$q$ 和 $-q$ 表示同一个旋转。模型在两个等价表示之间切换时数值上突然翻号,下游任何对四元数分量做回归或插值的代码都会输出瞬跳;
- RPY 在 $\pm\pi$ 处回绕:roll 从 $179°$ 到 $-179°$ 实际只转了 $2°$,数值上却差了 $358°$,回绕点附近还有万向锁;
- 而 6D 连续旋转表示 (Zhou et al. 2019) 和 3D 旋转向量 (axis-angle) 都没有这两个问题:连续、无奇异、无双覆盖。
所以深度学习里四元数最常用对状态编码基本成立,对动作回归输出不太成立。如果你的模型在输出四元数,跳变很可能有一部分来自双覆盖而不是模型本身,除非你和Curobo一样统一好符号。
来源三:绝对位姿的预测方差天然更大。要学的映射更难(要内化全局几何),输出自然更抖。修法还是回到 delta 化,配合对 delta 幅度做 clamp、chunk 重叠执行 + temporal ensembling 把逐帧噪声在时间上平均掉。剩下的最后一个问题就是:如果场景决定了必须用 task space(跨本体、人手数据) 那有没有一套把这些修法全部落实的现成方案?Qwen-RobotManip 就是。
5. 如果一定要用末端位姿
Qwen-RobotManip 是 Qwen-VL 系的操作基础模型:38100 小时预训练语料、15 个本体、零私采数据,真机上覆盖 AgileX ALOHA、Franka、UR、ARX。它的场景决定了不可能只选一种动作表示,所以它做的事情是把前面所有结论组装进一份统一的训练数据 schema,让 15 个本体的数据可以在同一个向量空间里对齐和训练。
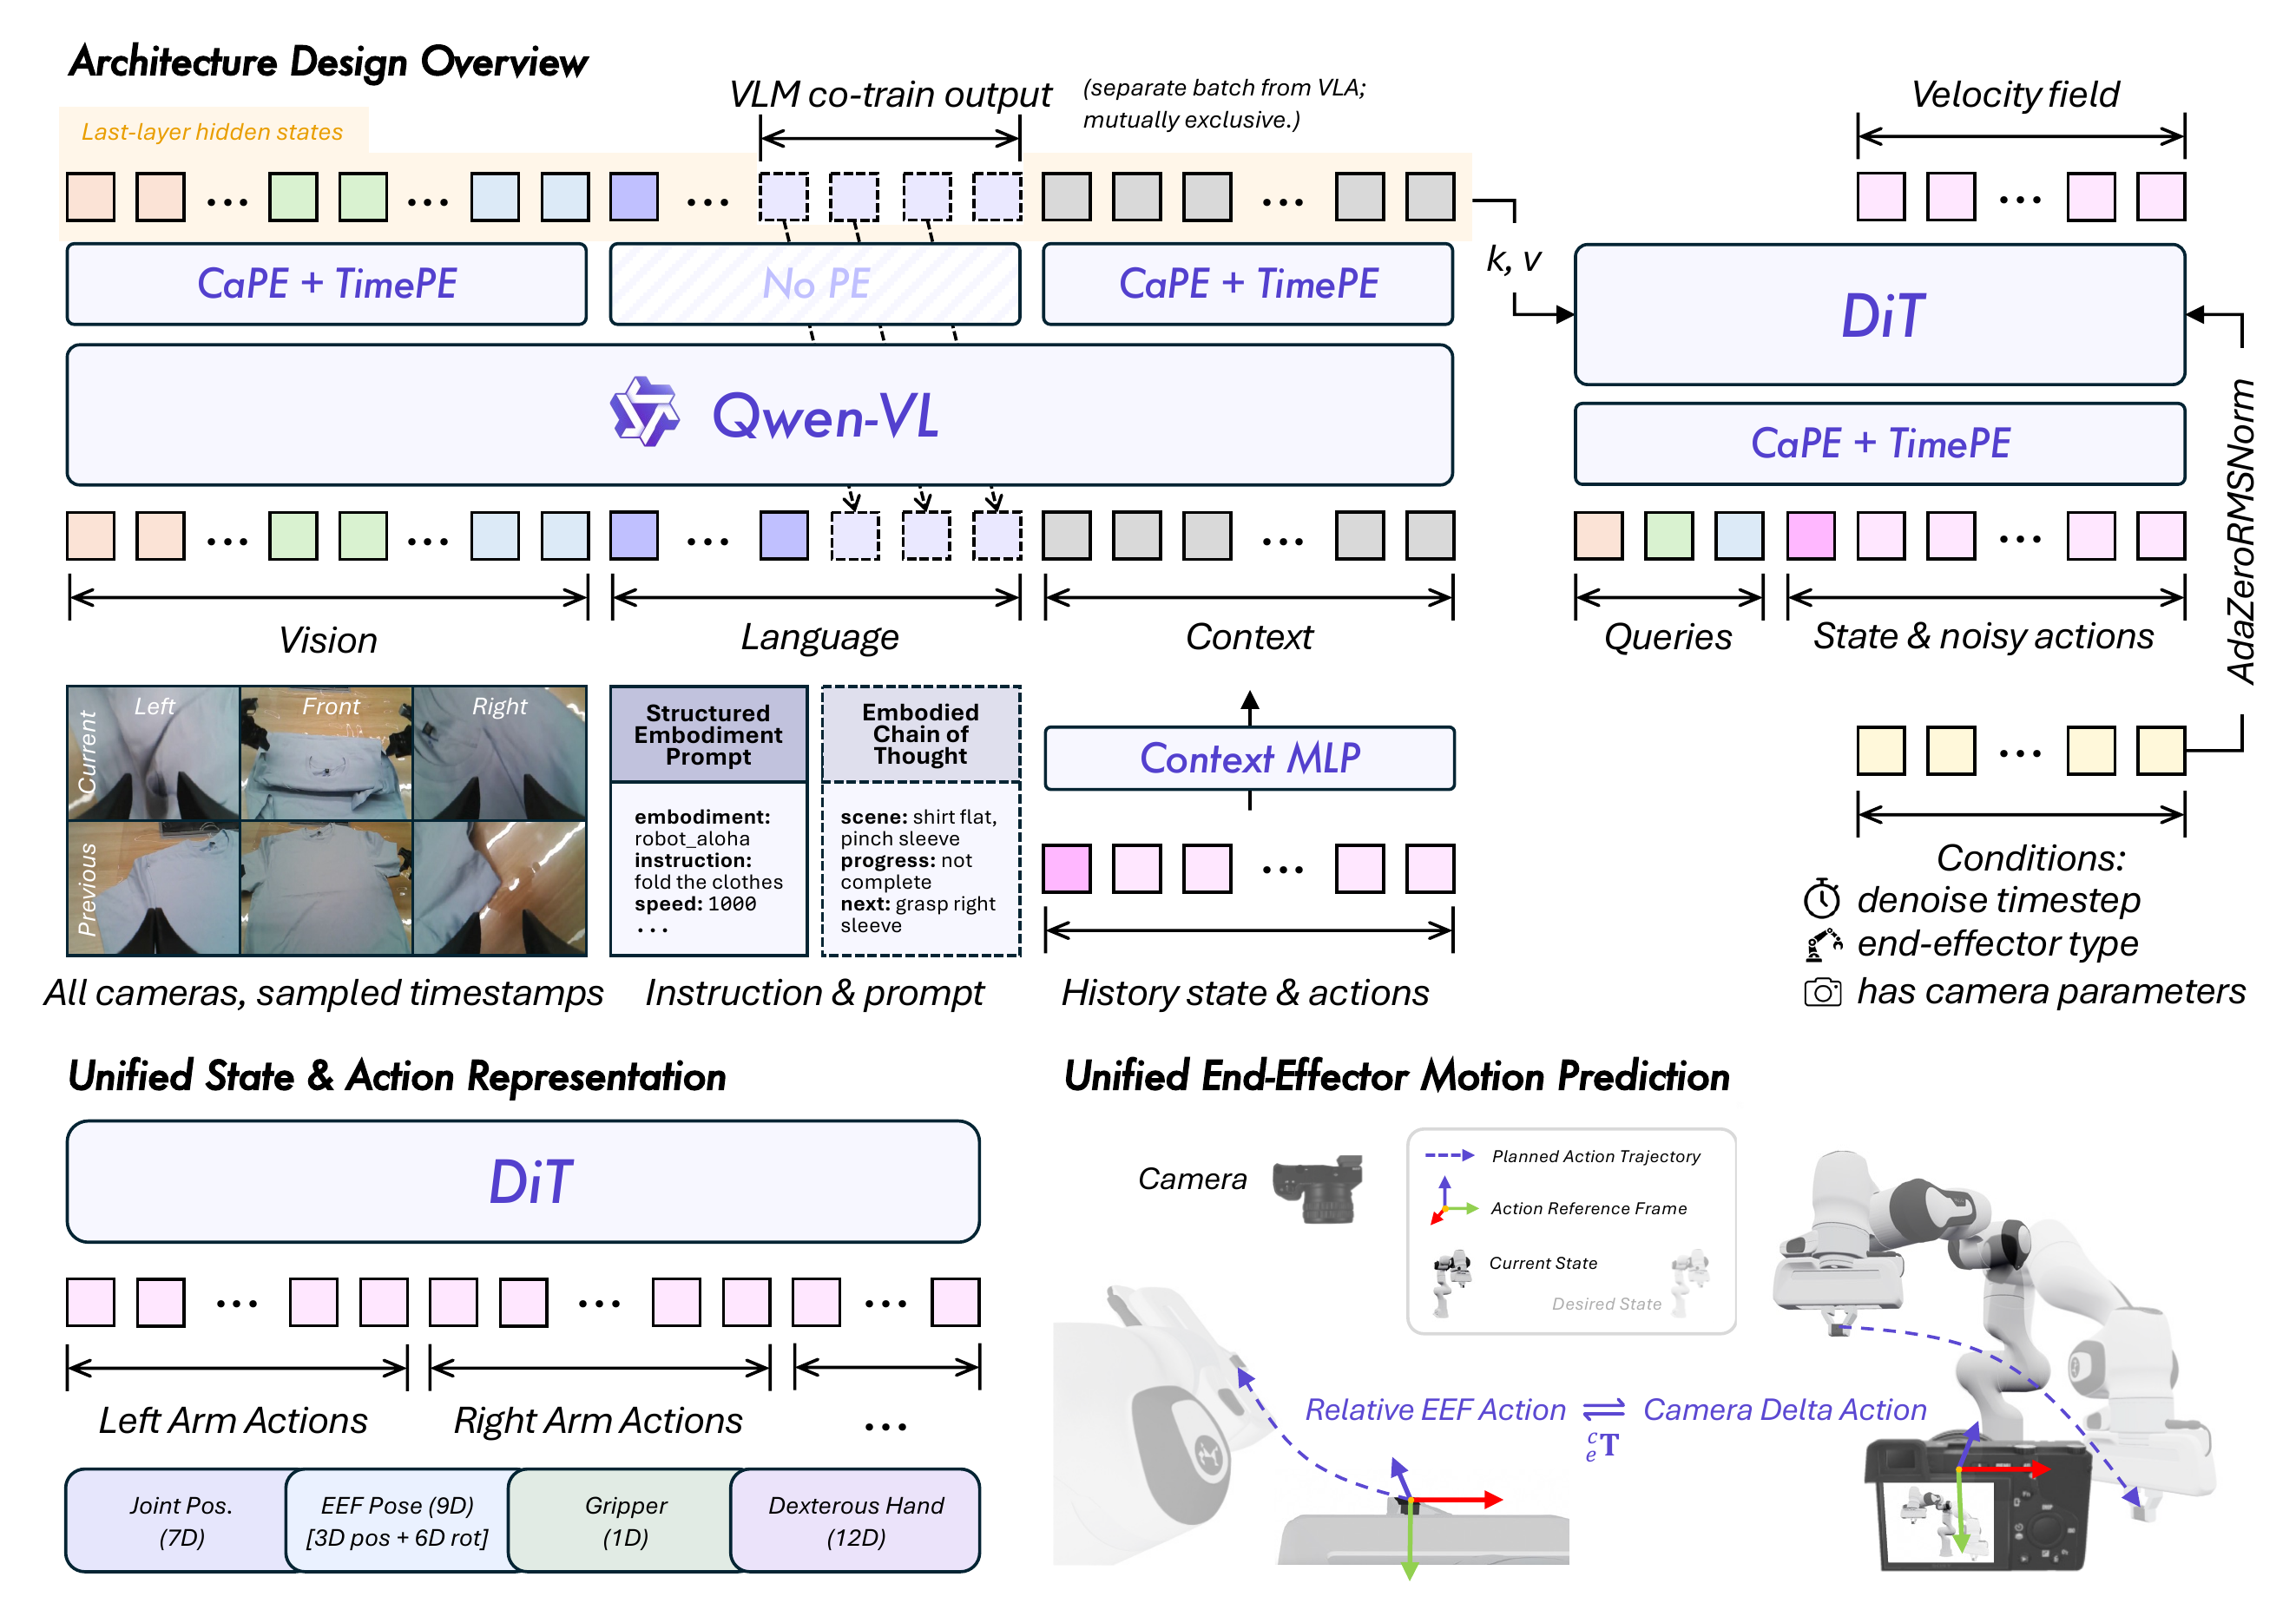
图 5:Qwen-RobotManip 总览。下方左图是 80 维统一状态/动作表示:每臂 29 维 = joint positions (7D) + EEF pose (9D, 3D pos + 6D rot) + 夹爪 (1D) + 灵巧手 (12D),不同本体只填充自己的子集;下方右图是统一的末端运动预测:Relative EEF Action 被重参数化为 Camera Delta Action。
骨架是一个 80 维规范表示:每臂 29 维 = joint (7) + EEF pose (9) + 夹爪 (1) + 灵巧手 (12),再加 22 维保留位(移动底盘等)。不同机器人只填充属于自己的子集,零填充维度通过 binary mask 从 loss 中剔除,防止本体数据量不均导致某些维度主导优化。动作类型上,joint 动作用绝对值,EEF 动作用相对当前状态的 delta, 注意 EEF 一侧正是第 2 节的 chunk-wise delta 结论。两种模式在 RoboTwin-Clean2Rand 上成绩几乎打平(Hard:joint 62.6% vs EEF 60.8%)
在这个骨架上,前面每一节的结论都能找到一个对应的设计,这是我读这篇论文时觉得最舒服的地方:
相机坐标系的 delta EE pose,对应第 3 节的泛化诉求 。EEF delta 不是定义在基坐标系,而是定义在相机坐标系下,理由相当优雅:在图像中看起来相似的动作,在动作空间中数值上也相近,让动作空间和视觉观测空间对齐,这样子第 3 节说的本体不变性从一条几何性质变成了可学习的对齐关系。结果是零样本迁移到三个未见机器人(ARX-X5、UR5-WSG、Franka Panda)拿到 23.9%,是 π0.5(7.5%)的 3.2 倍。这个方案依赖外参标定,论文专门留了一个 flag embedding,标定不可用时退回基座相对模式。
旋转表示分开选,对应 4.2 的来源二。State 里的姿态用 6D 连续旋转表示,EEF 动作的旋转增量用 3D 旋转向量, 刻意避开四元数和欧拉角。图 5 里 EEF pose 那一格写的 “[3D pos + 6D rot]” 就是这个选择:对状态,要的是连续可回归;对动作增量,要的是无回绕、无双覆盖。
数据清洗抓出的坑,对应 End Link vs TCP 与符号约定。它的五阶段数据清洗里专门有一阶段做 FK 一致性检查, 用 Pinocchio 从关节角重算 EE pose,和日志里的 EE pose 对账:
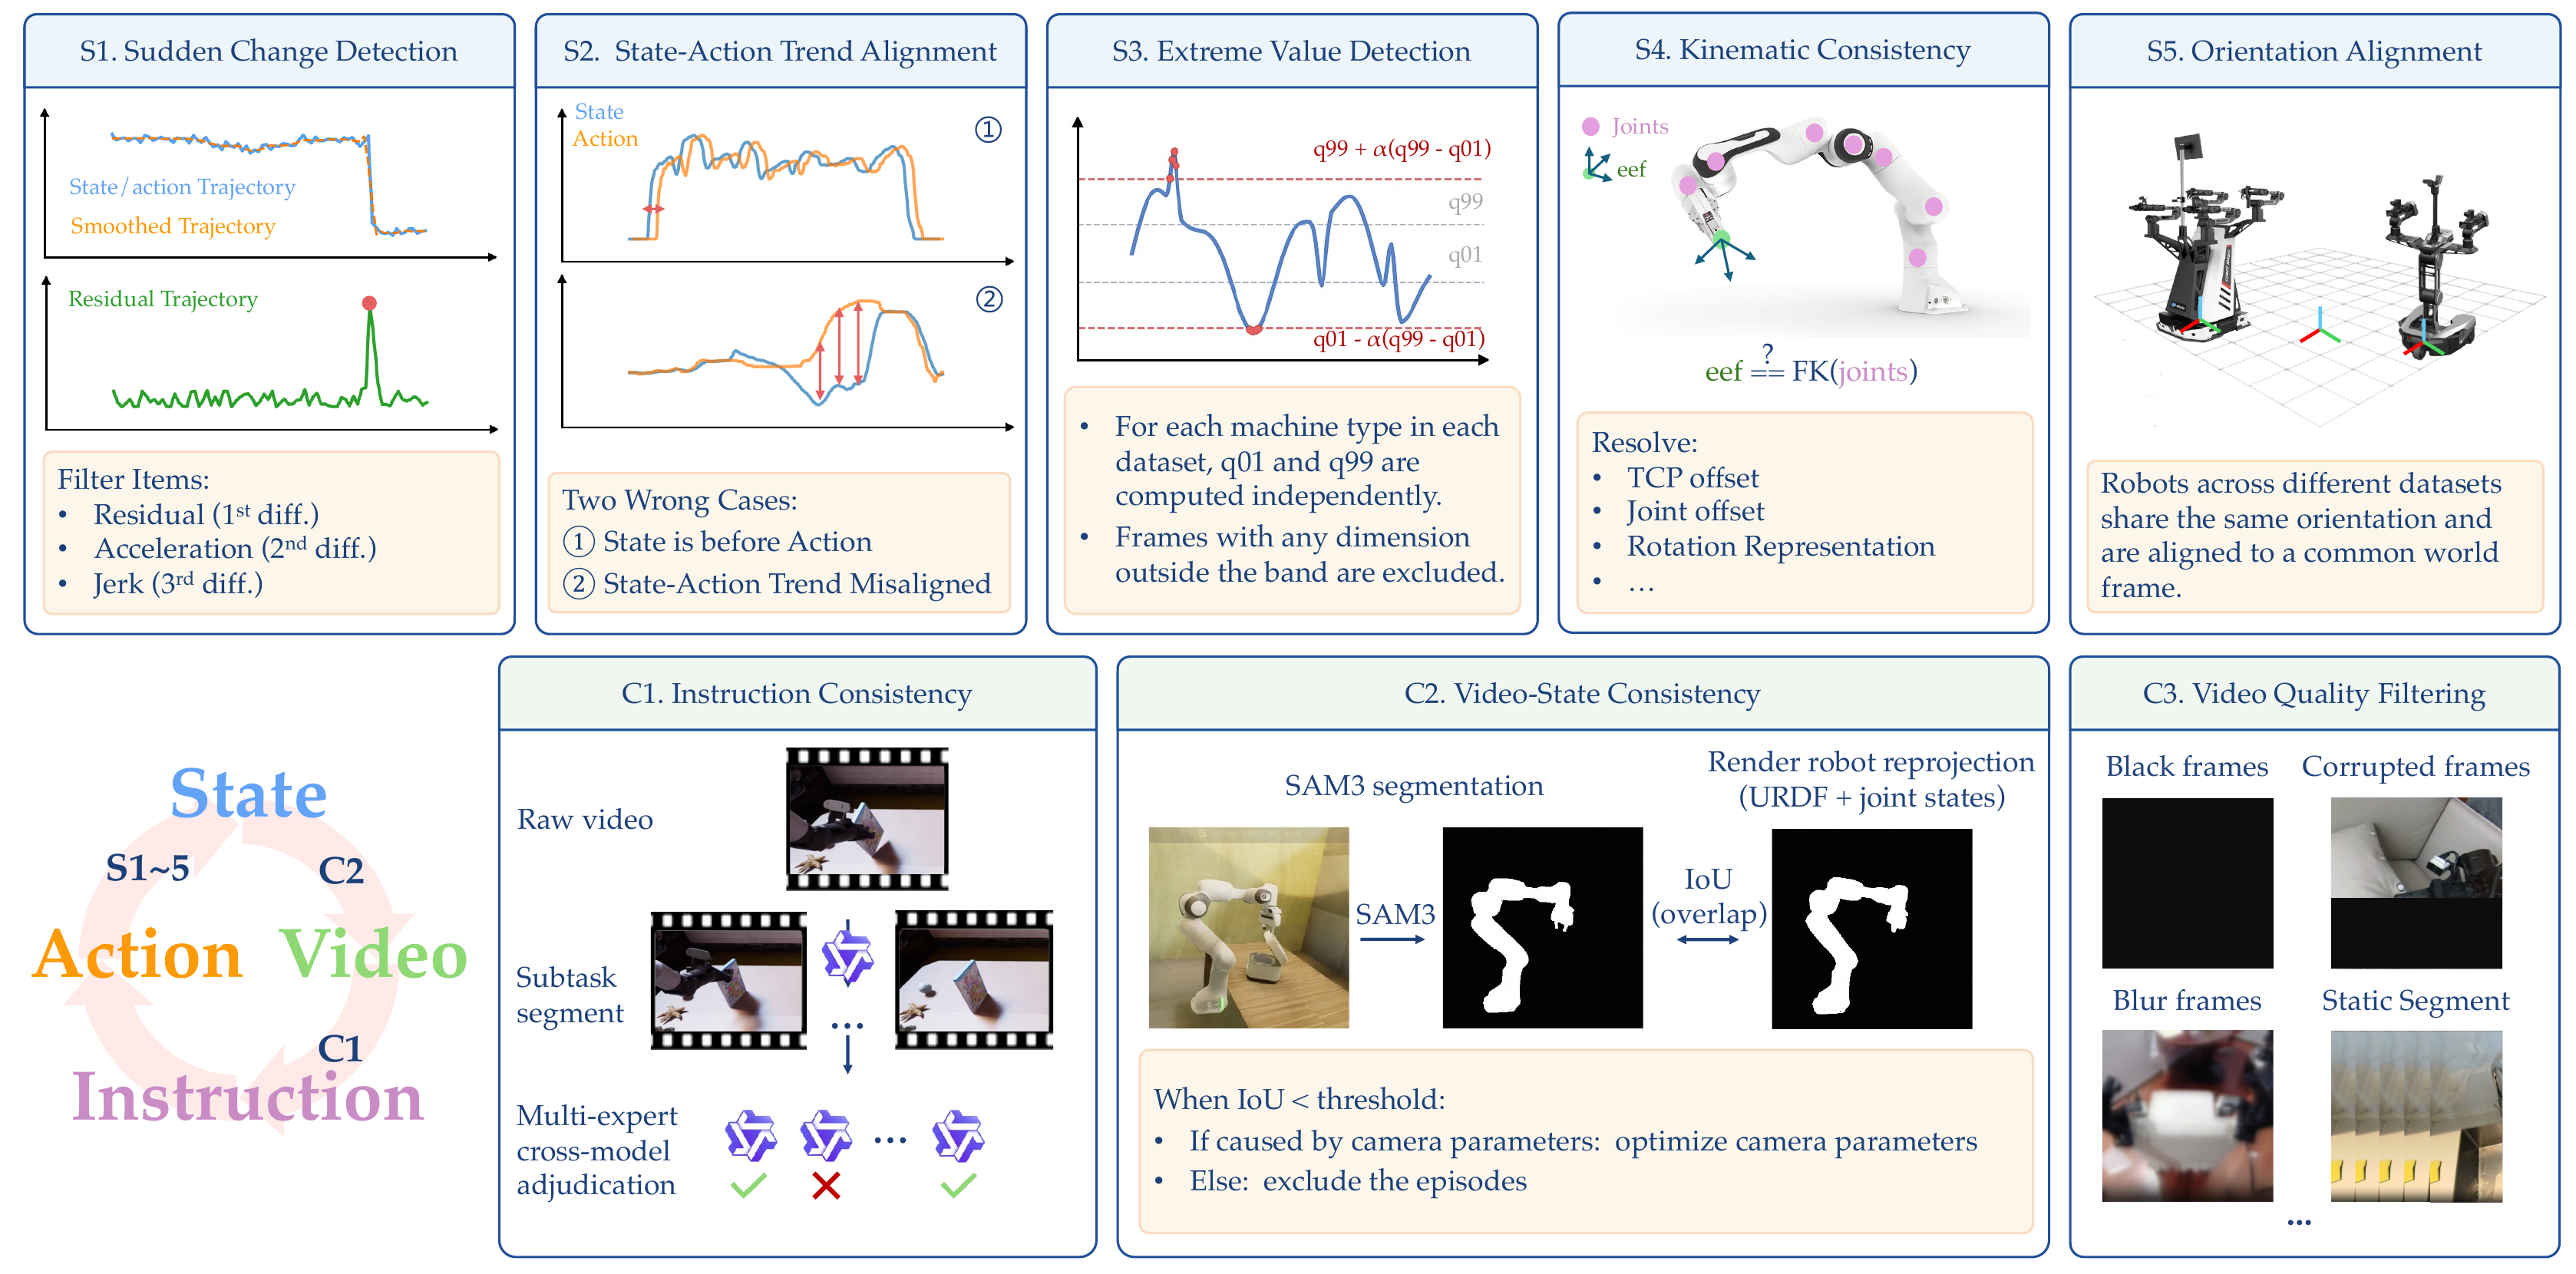
图 6:Qwen-RobotManip 的五阶段状态-动作清洗 + 三重跨模态质检。S4 Kinematic Consistency 检查 $\text{eef} \overset{?}{=} \text{FK}(\text{joints})$,需要消解的偏差恰好是 TCP offset、joint offset 和旋转表示。
7. 还有哪些问题没有解决?
最后照例留几个我认为这篇没有回答、未来值得盯的问题:
- RL 场景基本空白。两篇都建立在模仿学习上,RL 里 credit assignment 对动作表示的敏感性可能完全是另一套逻辑,delta 在 on-policy 采样下会不会引入额外偏差,不清楚;
- absolute 是否完全没戏?论文留了一个口子:absolute 可能对精确全局 grounding类任务有价值,只是更难训练。什么任务值得为它付这个代价?
- 动作表示能否学习?现在所有选择都是人工超参数,让策略自己学一个任务自适应的 action parameterization,也许是更终极的形态。
主要参考论文
- Yuchun Feng, et al. Demystifying Action Space Design for Robotic Manipulation Policies. arXiv:2602.23408, 2026.(13000+ 真机 rollout、500+ 模型的动作空间系统实证,本文图 1–4 均取自该论文)
- Qwen-RobotManip Technical Report: Alignment Unlocks. arXiv:2606.17846, 2026.(80 维规范表示、相机系 delta EE pose、6D 旋转、跨本体基础模型,本文图 5–6 取自该论文)
- Zhou et al. On the Continuity of Rotation Representations in Neural Networks. CVPR 2019.(6D 旋转表示的出处)